どうも、クラ本の黒田です。大変ご無沙汰しております。
あっという間に 11月になりましたね。そろそろ一年の振り返りをしてもいい頃合いではないでしょうか。
日々進化しているAI技術の中で、皆さんは今年、何に一番関わっていましたか。黒田が今年一番関わっていたのは、生成AI案件です。相談を受けて、評価して、提案して、作って、効果を測って。この繰り返しを何件かやって、ようやく「うちのやり方」として手順に落とせたので、今回はそれを書きます。
題材は、社内の技術文書を検索して質問に答える「対話型RAG」。架空の建設業A社を例にしますが、数字は実案件の記録をもとにしています(社名は仮名、一部は例示で補っています)。
最初に聞かれるのは「どのモデル使いますか」
生成AIの相談で、開口一番これを聞かれることが本当に増えました。
でも、PoCで止まった案件を振り返ると、つまずいた原因がモデルだったことは一度もない。つまずくのは全部その手前です。
- 対象の文書がどこにあるか分からない
- 解決したい課題が数字になっていない
- 誤回答が出たとき、誰が確認するのか決まっていない
この状態で構築に入ると、できたものを評価する基準がないので、「効果あったの?」に誰も答えられません。で、PoCで終わる。
だから今は、モデルの話は後回しにして、まず「準備度」を測るところから始めています。
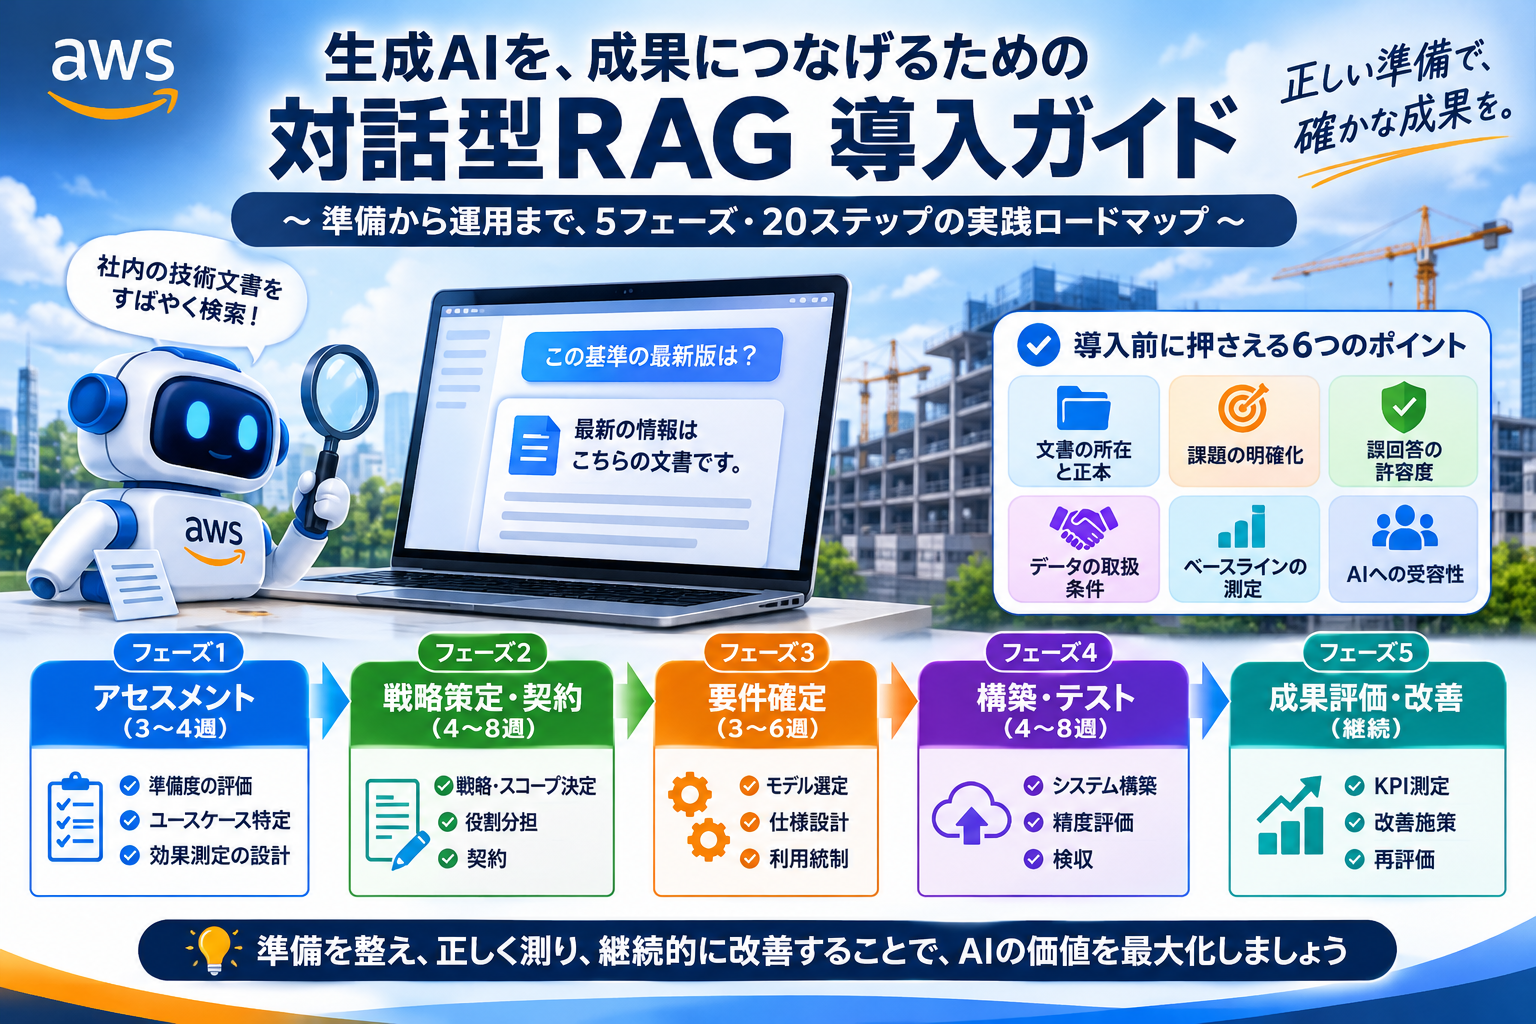
導入前に押さえておきたい6つのこと
方法論の前に、企業側で先に押さえておいてほしい話を6つ。全部「技術の話」じゃなくて「準備の話」です。
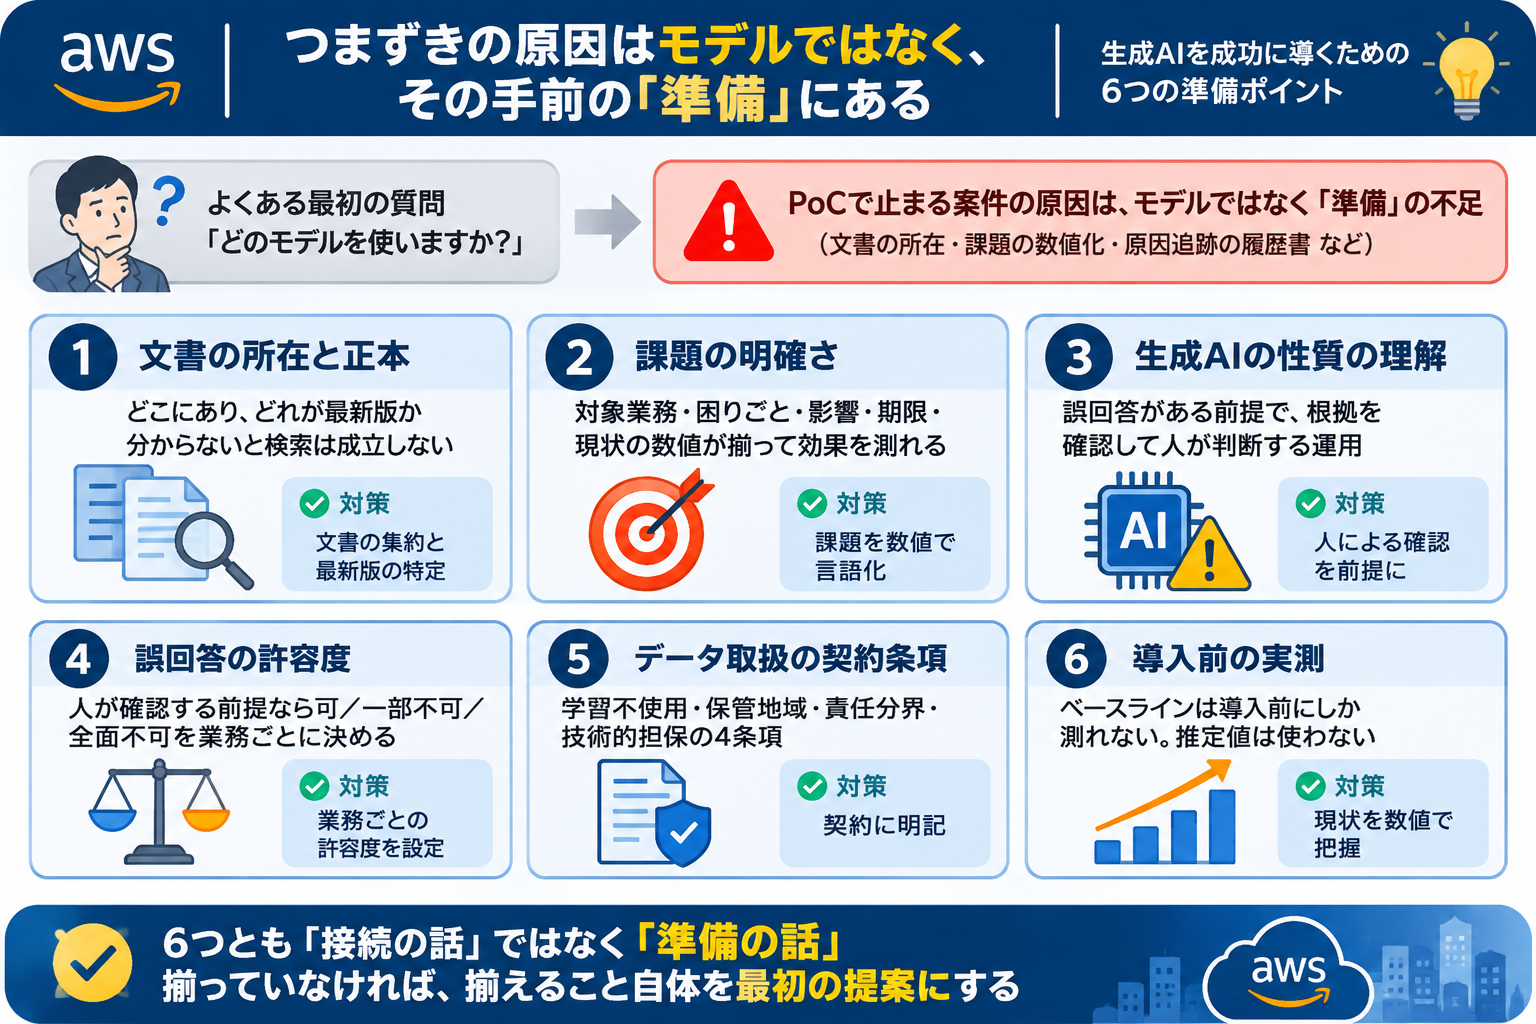
1. 文書の所在と正本が分からないと、検索は成立しない
RAGは社内文書を検索して、その内容をもとに答える仕組みです。個人PCと共有フォルダと紙台帳に散らばっていて、どれが最新版か分からない。この状態だと精度以前に「何を検索対象にするか」が決まりません。A社も大半は電子化されていたけど、正本が特定できない状態でした。
2. 「AIで何かしたい」では、効果を測れない
- 課題を「対象業務・困りごと・影響(誰が何に困るか)」で言えるか
- いつまでに解決したいか
- 現状が件数・時間・金額で分かっているか
この3つが揃わないと、導入後に効果の判定ができません。うちの方法論では、課題が特定されていない案件は総合評価を引き下げる「足切り」にしています。それくらい大事。
3. 生成AIは「自動で正解を出す道具」ではない
出力は確率的で、誤回答はあります。根拠を確認して人が判断する運用が前提。これを経営層と現場の両方が理解していないと、最初の誤回答で「使えないじゃん」になって終わります。見てきました。
4. 誤回答の許容度を、業務ごとに決めておく
「人が確認するなら可」なのか、「一部業務では不可」なのか、「全面的に不可」なのか。ここが用途・モデル選定・合格基準の全部に効いてきます。
5. データの取扱条件を契約に書く
学習に使わない、保管地域、責任分界、暗号化などの技術的担保。この4つは契約条項にして、設計書で担保方法を示す。口頭説明や提案書の一文だけだと、後から確認できません。
6. 導入前の数値を、導入前に測る
効果は、導入前の実測値(ベースライン)と比べて初めて示せます。そしてベースラインは導入前にしか測れない。「だいたい1件30分くらい」みたいな推定値は、稟議にも実績評価にも使えません。契約前に必ず測ります。
方法論の全体像:5フェーズ・20ステップ
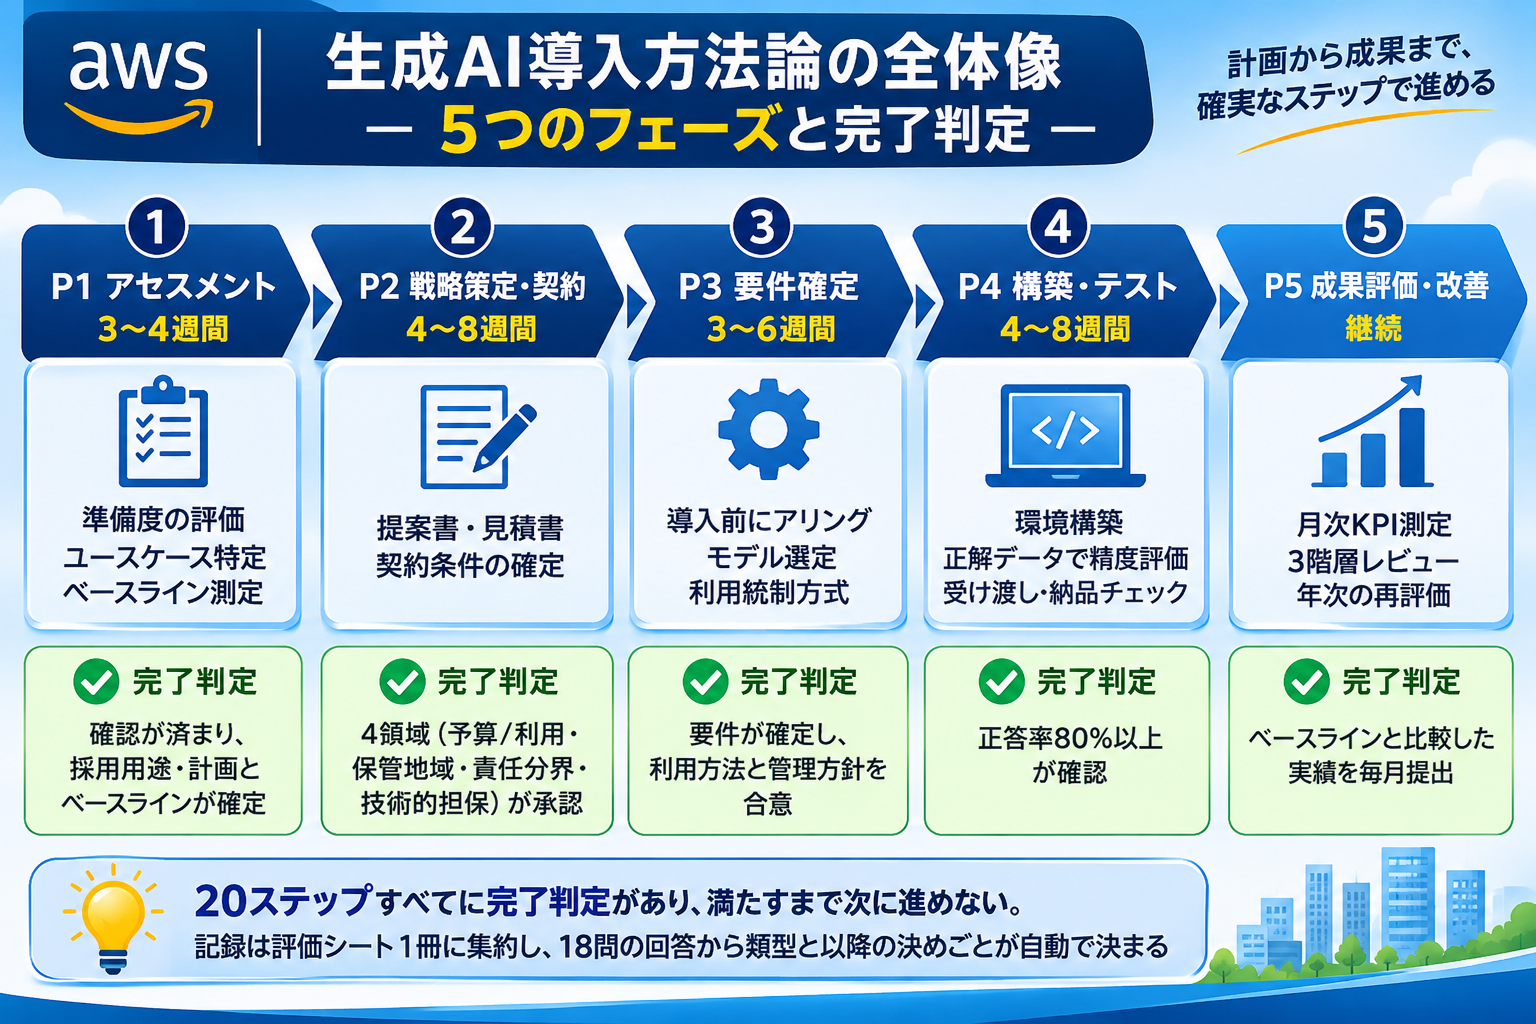
担当者が代わっても同じ手順で同じ判断に至る。これが目的です。
| フェーズ | 期間の目安 | やること | 成果物 |
|---|---|---|---|
| P1 アセスメント | 3〜4週 | 準備度の評価、ユースケース特定、効果測定の設計 | 評価結果報告書、ユースケース候補一覧、ベースライン測定結果 |
| P2 戦略策定・契約 | 4〜8週 | 戦略・スコープ・役割分担の合意 | 提案書・見積書、契約書 |
| P3 要件確定 | 3〜6週 | モデル・仕様・利用統制の確定 | モデル選定記録、利用統制設計 |
| P4 構築・テスト | 4〜8週 | 構築と品質確認 | 稼働環境、精度評価結果、検収書 |
| P5 成果評価・改善 | 継続 | KPI実測と教訓の反映 | 月次運用レポート、レビュー議事録、再評価結果 |
各ステップに完了判定があって、満たすまで次に進めません。P1なら「評価の類型が決まり、採用ユースケースが1件以上あり、ベースライン4項目が実測で揃う」まで完了にならない。
記録は全部1冊の評価シート(Excel)に集約していて、18問の回答を入れると総合レベルと提案類型が自動で決まる作りです。人の裁量で結果が変わらないようにしています。
準備度評価:クラウド導入チェックと何が違うか
4観点+AI固有の2観点
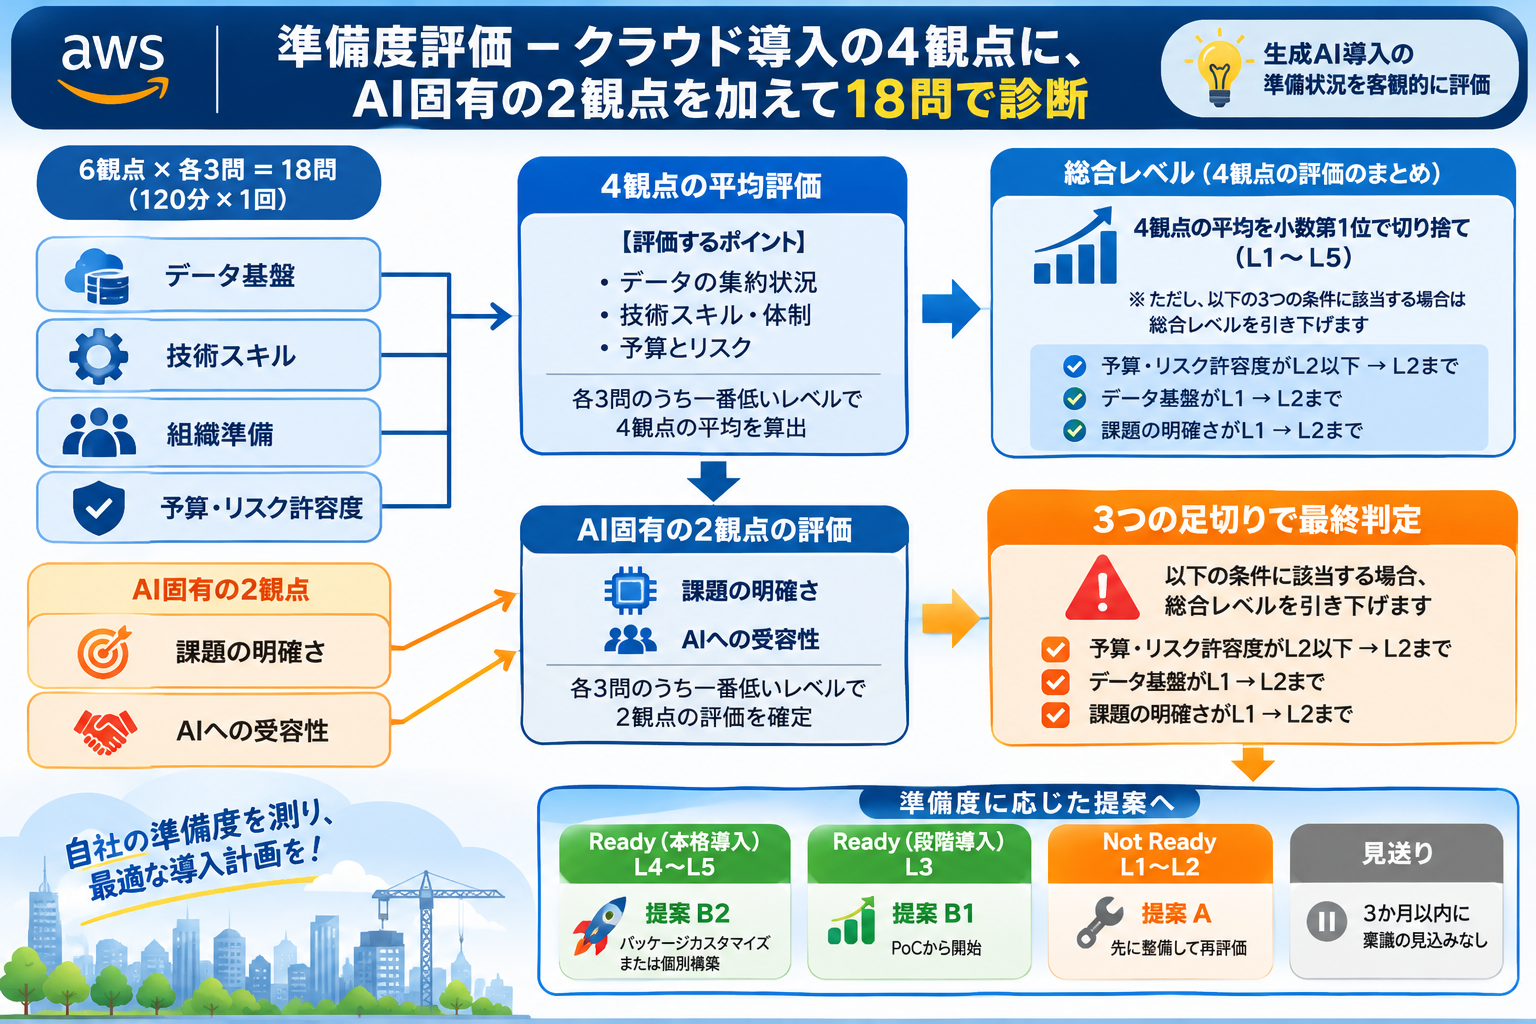
クラウド導入のアセスメントは、データ基盤・技術スキル・組織体制・予算の4つで足ります。生成AIはここに 「課題の明確さ」 と 「AIへの受容性」 の2つを足します。この2つが、クラウド導入と生成AI導入を分けるところ。
| 観点 | 問うこと | 最初に聞く一言 |
|---|---|---|
| データ基盤 | 文書が電子化・集約され、版と機微度が分かるか | 「その文書をいま誰かが探すとしたら、どこを見ますか」 |
| 技術スキル | クラウドと生成AIの運用を誰が担うか | 情シス体制、AWS経験、生成AI経験 |
| 組織準備 | 推進者・利用統制・現場の受容 | 推進責任者、承認制やログ取得の方針、パイロット部門 |
| 予算・リスク許容度 | 誤回答の許容度、データ取扱制約、合格基準を文書で合意できるか | 予算と決裁者、誤回答の許容度 |
| 課題の明確さ(AI固有) | いつまでに・何を・どの数値で解決するか | 「いま一番時間を取られているのは何で、いつまでに何とかしたいですか」 |
| AIへの受容性(AI固有) | 小さく試して、誤回答前提で使いこなす文化があるか | 直近の新技術導入実績、PoCを認める決裁の仕組み |
各観点3問、計18問。ヒアリングは120分1回です。
AWSのCloud Adoption Framework for AIには Business/People/Governance/Platform/Security/Operations の6視点がありますが、うちの6観点はこれに対応づけてあります。「課題の明確さ」はBusiness、「AIへの受容性」はPeople。ただし問いと基準は実案件から作りました。
証跡で判定する。印象で採点しない
採点には3つルールがあります。
証跡主義。 回答だけじゃなく、共有フォルダ・体制図・社内規程・AWSコンソールの現物を見ます。3問とも自己申告だけなら、その観点は自動で1段階下げる。
ヒアリングの場で採点しない。 判定は場を離れてから、ルーブリック(状態の定義)に照らして。同じ回答なら誰が採点しても同じレベルになる選択式です。
3問の最小値を採る。 観点のレベルは3問のうち一番低い状態に合わせます。1つでも下があればそこ止まり。
総合レベルと3つの足切り
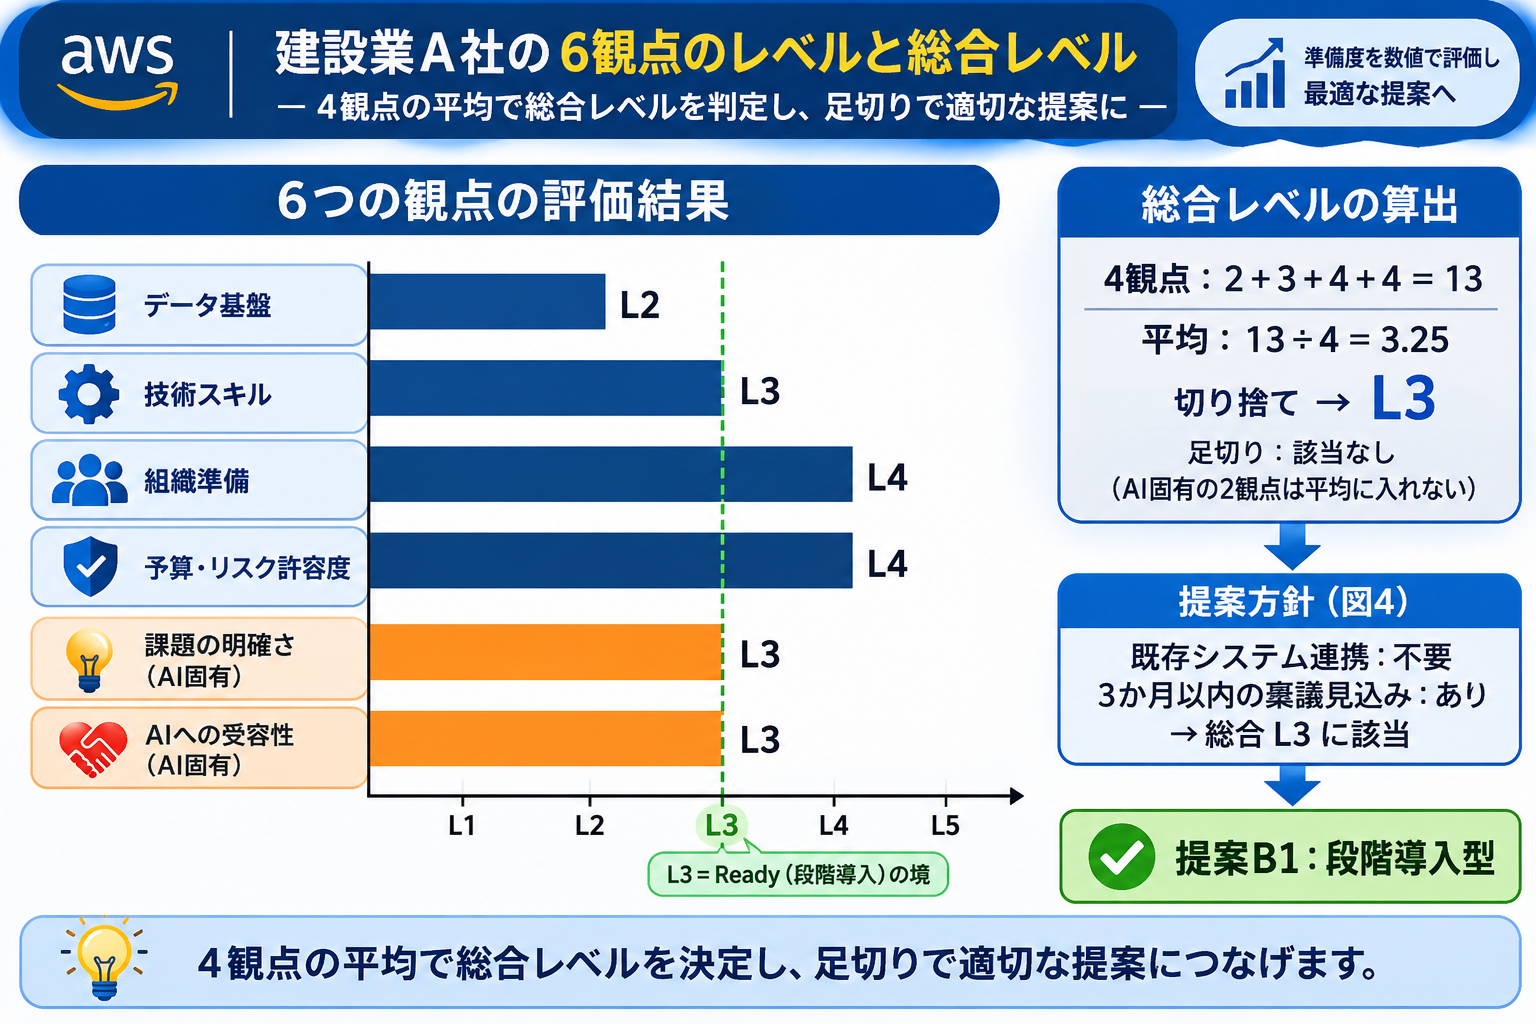
総合レベルは4観点(データ・技術・組織・予算リスク)の平均を小数第1位で切り捨て。AI固有の2観点は平均に入れません。過去案件と比較できるようにするためで、代わりに「提案の中身」を決めるのに使います。
で、平均を出したあとに足切りを当てます。足切りは引き下げにだけ使って、引き上げには使いません。
| 足切り | 条件 | 理由 |
|---|---|---|
| 1 | 予算・リスク許容度がL2以下 → 総合はL2まで | 予算と決裁がなければ案件として成立しない |
| 2 | データ基盤がL1 → 総合はL2まで | 電子化されてなければ検索が成立しない |
| 3 | 課題の明確さがL1 → 総合はL2まで | 課題がないと効果を測れず、合格基準も決められない |
ちなみに技術スキルがL1(クラウドも生成AIも初めて)でも足切りにはしません。それは「うちが運用を代行する範囲を決める材料」であって、導入できない理由じゃないので。
Readyとは何か。Readyじゃないとき何を提案するか
ここ、誤解されやすいので強調しておきます。準備度評価は 合否判定じゃない。「どの提案から始めるか」を決めるためのものです。
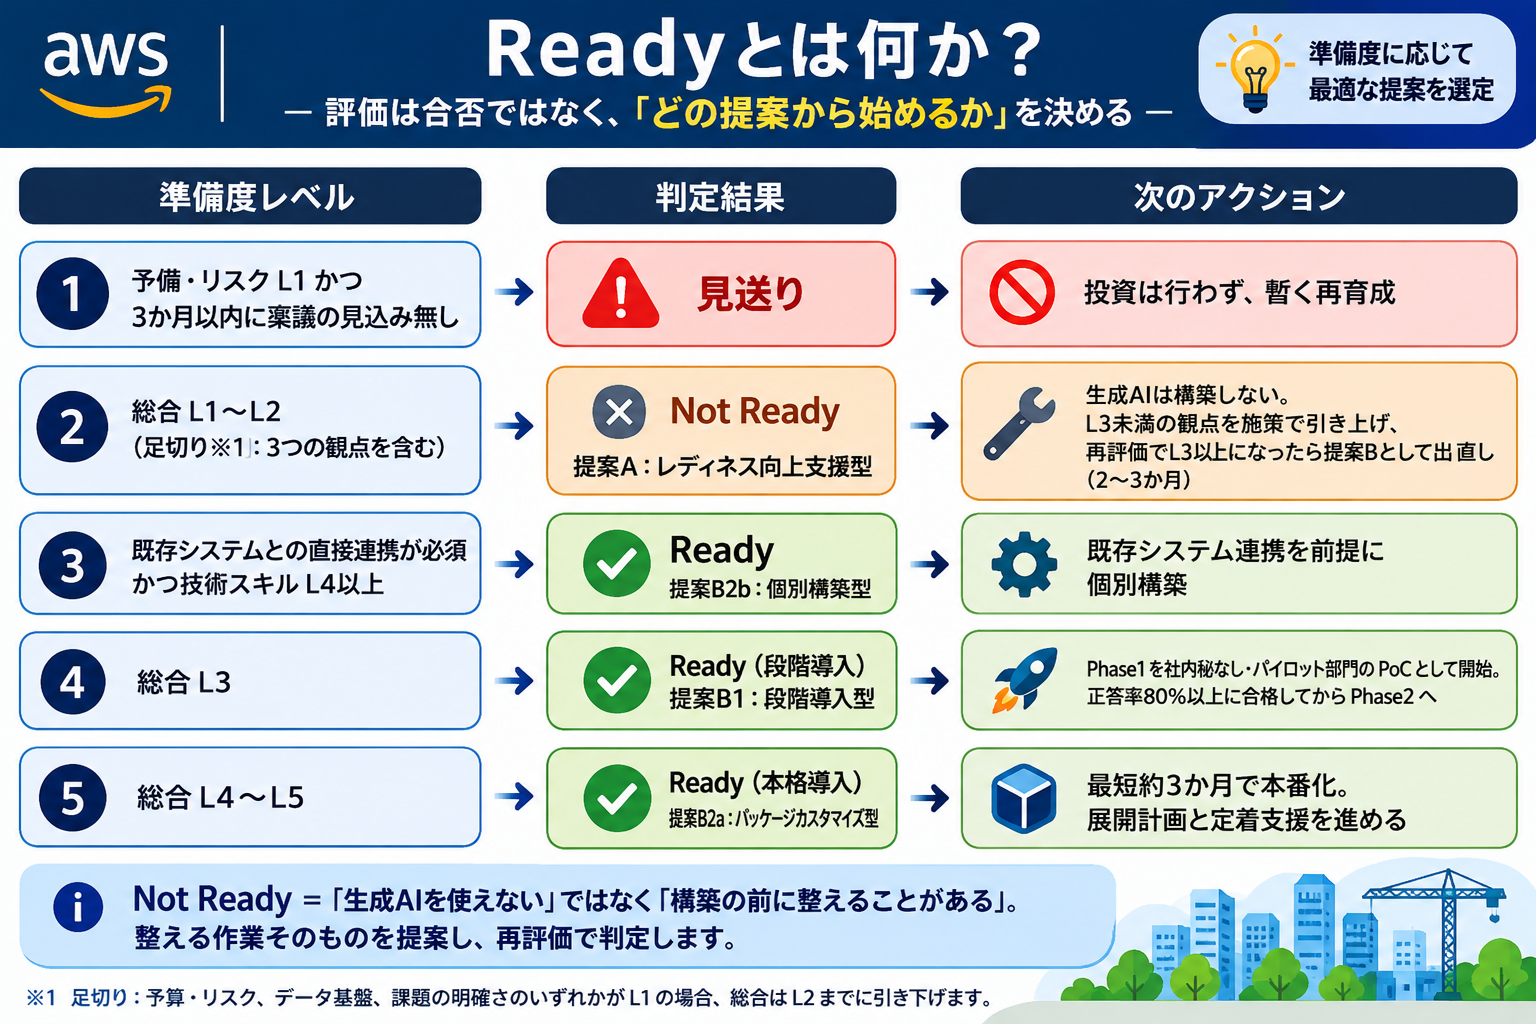
Not Readyは「生成AIを使えない」じゃなくて「構築の前に整えることがある」という意味。で、その整える作業そのものを提案します。
| 判定 | 総合 | 提案するもの |
|---|---|---|
| Ready(本格導入) | L4〜L5 | 提案B2。パッケージをカスタマイズするB2a、既存システム連携必須で技術L4以上なら個別構築のB2b。最短約3か月で本番化 |
| Ready(段階導入) | L3 | 提案B1。Phase1を社外秘なし・パイロット部門のPoCとして小さく始め、正答率80%以上で合格してからPhase2へ |
| Not Ready | L1〜L2 | 提案A。生成AIは作らず、L3未満の観点を施策で引き上げ、再評価でL3以上になったら提案Bとして出し直す(2〜3か月) |
| 見送り | 予算・リスクL1かつ3か月以内に稟議の見込みなし | 提案は作らず、施策で再育成 |
総合レベルが同じでも、観点別のレベルで提案の中身は変わります。
| 観点 | L1〜L2のときに提案すること | 提案Bのときに反映する先 |
|---|---|---|
| データ基盤 | 文書の棚卸し → 保管場所の統合方針。Phase1は初期データなしで構築し、集約後に投入 | データ準備工数と段階計画 |
| 技術スキル | フルマネージド前提の役割分担 → AWS基礎研修。初めてでもうちが運用代行 | 役割分担と教育・サポート範囲 |
| 組織準備 | 推進責任者の指名支援 → ユースケース発掘ワークショップ | 利用統制方式と展開計画 |
| 予算・リスク | ベースライン測定(稟議に使える数字)→ 段階導入によるリスク設計 | 提案類型・モデル選定条件・合格基準 |
| 課題の明確さ | 課題の棚卸しワークショップ → 定量化と期限設定 | ロードマップ骨子とKPI目標値 |
| AIへの受容性 | 生成AI体験会 → パイロット部門選定とPoC計画 | Phase1の範囲と展開計画の要否 |
施策は20種類カタログ化してあって、L1の観点は2施策、L2は1施策で1段階ずつ上げます。実施順は 「課題の明確さ → 予算・リスク → 組織・受容性 → データ → 技術」 で固定。課題が定まらないと測る対象も棚卸しの範囲も決まらないし、効果が数値化されないと以降の施策に予算が付かないからです。
作例:建設業A社の社内文書RAG
ここからA社の話。評価シートの記入例に沿って追います。
課題
技術部門の担当者が、安全基準書・品質管理基準書・検査要領書といった社内技術文書について照会を受けている。該当箇所を探す、有識者に聞くのに時間がかかって、回答待ちが現場の作業を止めていた。
評価結果
| 観点 | レベル | 現状の要約(顧客に見せた文) |
|---|---|---|
| データ基盤 | 2 | 大半は電子化され共有フォルダに集約。ただし個人PC・複数フォルダに分散し正本が特定できない。社外秘の区分は文書化されていない |
| 技術スキル | 3 | 情シス専任あり、本番運用経験あり。AWSは本番実績あり。生成AIは検証レベル |
| 組織準備 | 4 | 推進者が指名され周知済み。承認制・ログ取得の方針あり。複数部門で受容性を確認 |
| 予算・リスク許容度 | 4 | 予算枠と決裁者が特定済み。誤回答の許容範囲が業務規程で明確。データ取扱規程あり |
| 課題の明確さ | 3 | 課題は文書化され「いつまでに」は担当者間で共有。現状の数値は概算で一部のみ |
| AIへの受容性 | 3 | 新技術に前向き。推進担当は生成AIの性質を理解しているが現場には伝わっていない。PoC実績と決裁ルートあり |
4観点の平均3.25 → 切り捨てて L3。足切り該当なし。既存システムとの直接連携は不要、3か月以内に稟議の見込みあり、ということで 提案B1(段階導入型) に決まりました。
顧客にはレベルの数字じゃなくて「現状の要約」を見せて、事実と合っているかだけ確認します。A社からは「相違なし。文書の分散はS3への集約を別途計画したい」との回答でした。
ロードマップ骨子
- 解決したい課題:技術文書の該当箇所を探す・有識者に聞くのに時間がかかり、回答待ちが現場を止めている
- いつまでに:2026年度末(回答待ちを無くす)
- 現状の数値:月320件、1件20分、回答待ち平均4.0時間(後述の実測値)
- 第1弾の用途:社内技術文書の検索・質問応答
- 段階:受容性L3なのでPhase1はPoC、正答率80%以上で合格してから展開計画。データ基盤L2なのでPhase1は初期データなしで構築・納品
ユースケースの絞り込み:要望があっても不適合なら採らない
発掘ワークショップで出た候補を3軸で判定。3つとも適合のときだけ採用します。
| 候補 | ①誤回答の業務影響 | ②正解データの有無 | ③人によるレビュー | 判定 |
|---|---|---|---|---|
| 社内技術文書の検索・質問応答 | ○ | ○ | ○ | 採用(1位) |
| 汎用のAI対話機能 | ○ | ✕ 正解が定義できず品質を測れない | ○ | 見送り |
| 施工計画書・安全書類の下書き | ○ | ○ | ○ | 採用(2位) |
| 現場の安全是正の可否判断 | ✕ 安全に直結する最終判断 | ○ | ○ | 見送り |
| 協力会社への回答メール自動送信 | ○ | ○ | ✕ 出力がそのまま最終出力になる | 見送り |
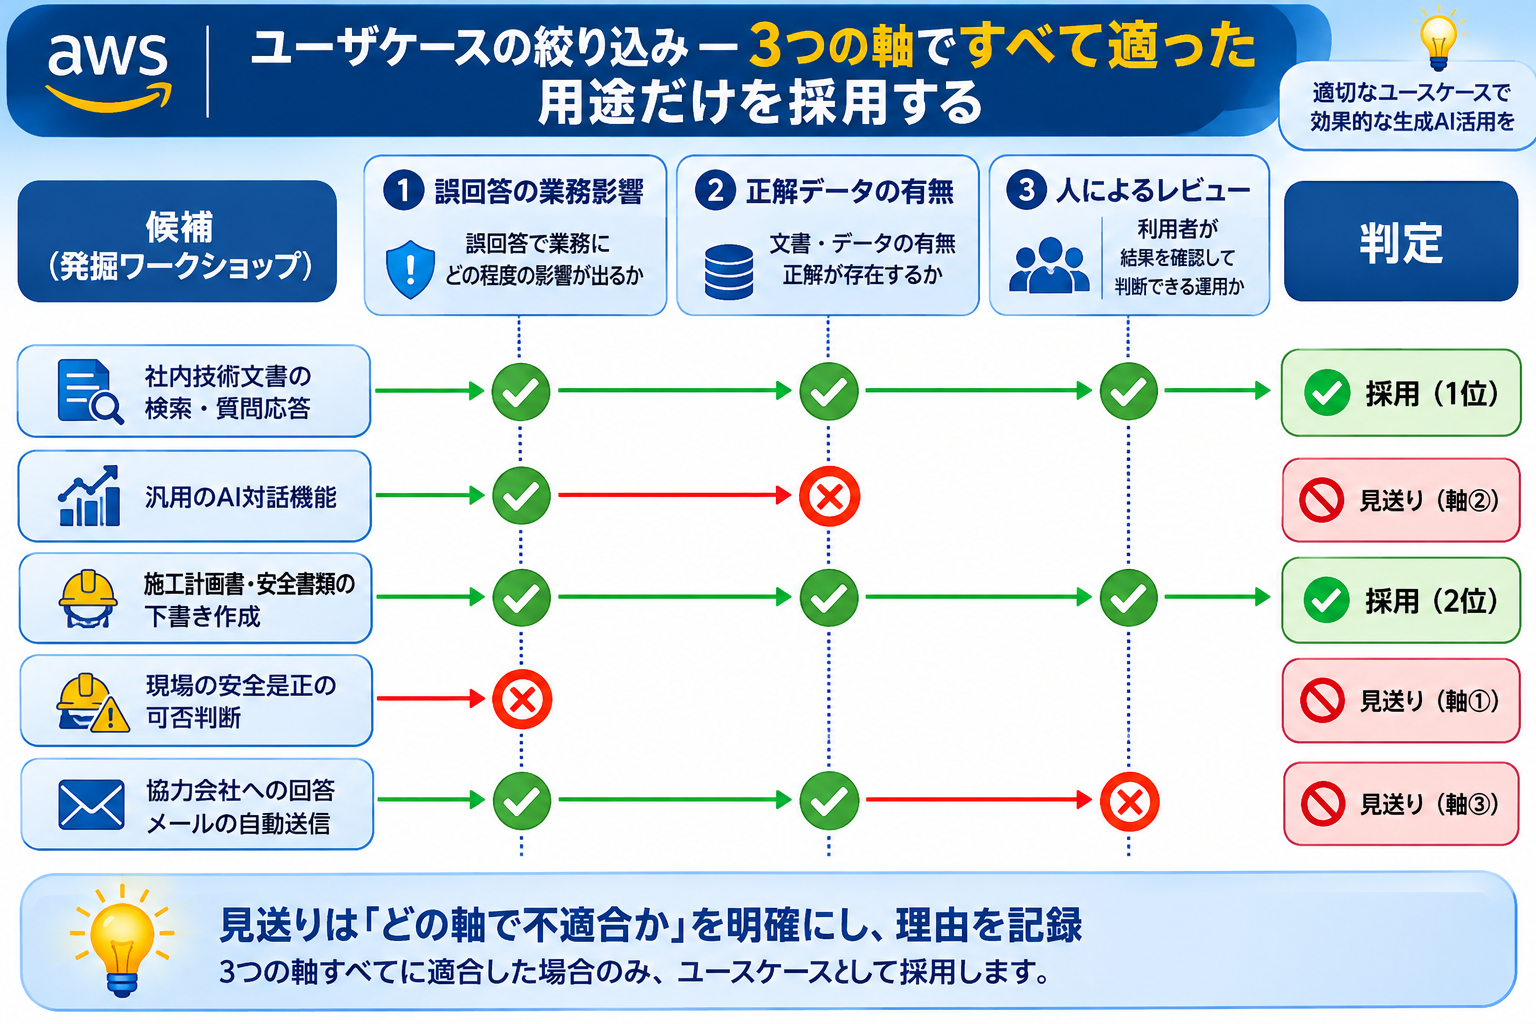
「汎用のAI対話機能」はほぼ必ず要望に挙がります。でも正解が定義できないから品質を測れない。ここで受けると後の精度評価で絶対に行き詰まります。断る理由は軸の番号つきで書面に残します。
ベースライン測定:n=40の調査票
A社には問い合わせ台帳がなかったので、調査票でサンプリングしました。
- 設計:母集団=技術部門担当者の社内技術文書に関する照会対応、期間内全件、実測(時刻記録)、10営業日、目標n=40
- 記入:1件1行で「受けた時刻/回答した時刻/実作業時間」。待ち時間は自動計算。開始時に5分説明して記入例を1件一緒に書く
- 結果:40件回収。1件あたり平均20分、回答待ち平均4.0時間、月間推計320件(157件 ÷ 10営業日 × 20.4)
- 金額換算:人件費単価4,000円/時(総務に依頼)→ 年間1,280時間、512万円
調査票の備考欄には「安全基準書のどの章か分からず紙を2冊めくった」「最新版かの確認に時間がかかった」「終業間際の依頼で翌朝回答」といった声が並びます。ベースラインは数字だけじゃなくて、こういう困りごとの実態も残しておく。
あと大事なのは、調査設計(母集団・抽出方法・測定方法・期間)を書き残すこと。これがないと第三者が再現できず、ベースラインとして使えません。
契約:4条項が揃って初めて締結
- 学習不使用(顧客データを学習に使わない)
- 保管地域(国内保管。リージョン指定を設計書と条項の両方に)
- 責任分界(技術スキルのレベルに応じた役割分担と整合)
- データ取扱の技術的担保(暗号化・TTLなど。担保方法は設計書に)
1つでも未対応なら契約前に手当て。A社は予算・リスクL4だったので追加施策なしで条項化できました。あわせて効果測定の目標値を「効果測定に関する確認書」として数値で合意します。合意のない目標は実績評価に使いません。
段階的導入:機微度でデータを切る
Phase1は社外秘を含まない情報に限定。A社ではさらに踏み込んで、初期データをゼロにした状態で構築・納品し、顧客データを含まない受け渡しを担保しました。検収後に顧客側でナレッジを格納し、KMS暗号化・承認制・国内保管の統制下でPhase2(社外秘含む)へ。移行条件はPhase1の精度評価合格で、提案書と契約に明記。
精度評価:正解データ20問、正答率80%以上
納品前に、顧客の有識者と一緒に「期待される答え」と根拠文書を確定した正解データで測ります。「登録あり」と「登録なし」に分けて、後者は「見つからない旨と問い合わせ先を案内できたか」で判定。
| カテゴリ | 問数 | 正答 | 正答率 |
|---|---|---|---|
| 登録あり | 17 | 14 | 82.4% |
| 登録なし | 3 | 3 | 100% |
| 合計 | 20 | 17 | 85% |
合格基準80%クリアで受入合格。
不正解の3問は「検索結果に正解文書が出ているか」で切り分けます。出ていなければ検索起因(インプット拡充、メタデータ・チャンク設計、リランキング)、出ていれば出力起因(プロンプト、モデル選定、表示内容)。改善は1つずつ当てて、同じ正解データで再評価。切り分けずにプロンプトだけ触っても直りません。 3回やって届かなければ、用途そのものを適合判定に戻します。
導入後:月次KPIと3階層レビュー
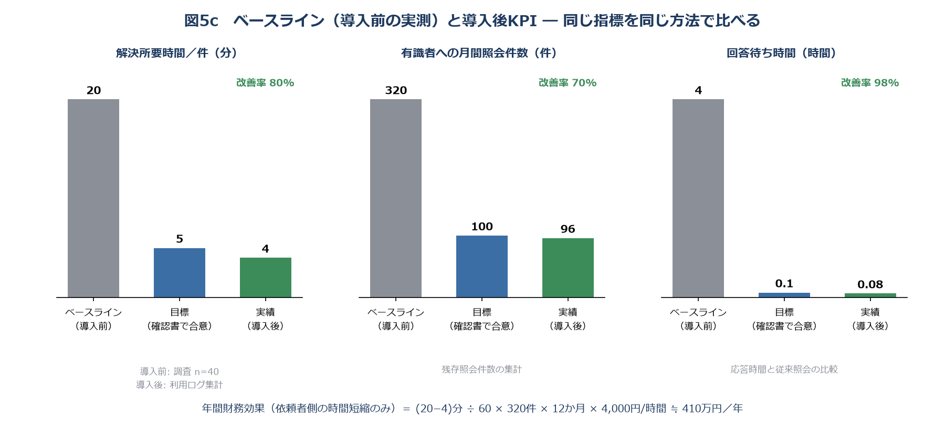
ベースラインと同じ指標を利用ログから毎月実測。推定値は使いません。
| KPI | ベースライン | 目標 | 実績 | 改善率 |
|---|---|---|---|---|
| 解決所要時間/件 | 20分 | 5分 | 4分 | 80% |
| 有識者への月間照会件数 | 320件 | 100件 | 96件 | 70% |
| 回答待ち時間 | 4.0時間 | 0.1時間 | 0.08時間 | 98% |
年間財務効果は 約410万円((20−4)分 ÷ 60 × 320件 × 12か月 × 4,000円)。
レビューは運用(月次・IT部門長と運用担当)、戦術(3か月・IT部門長とPM)、戦略(四半期・経営層、ROIと投資判断)の3階層。目標に届かないときは「利用が伸びていない」のか「精度が足りない」のかを切り分けて打ち手を変えます。
教訓は標準に戻す
案件で起きたことは案件で直して終わりにしません。A社では「表がチャンク分割で分断されて項目が欠落」「旧版文書の値が回答に使われた」の2件を、表単位のチャンク保持と最新版優先フィルタとして標準手順に格上げしました。
1年後の再評価:L3 → L4
本番稼働から1年ごとに、同じ様式・同じルーブリックで再評価します。S3集約とメタデータ整備(データ基盤2→4)、操作マニュアルによる運用引き継ぎ(技術3→4)、合格基準の文書化(予算・リスク4→5)で総合L4。次は提案B2a(パッケージカスタマイズ型)として本格導入を提案する流れです。受容性もPoCを経て現場に生成AIの性質が伝わり、3→4に上がっています。
おわりに:相談の前に自社で確認できること
方法論を一言でいえば 「準備度を証跡で測り、測った結果から提案の型を決め、導入前と導入後の数値を同じ指標で比べる」 です。
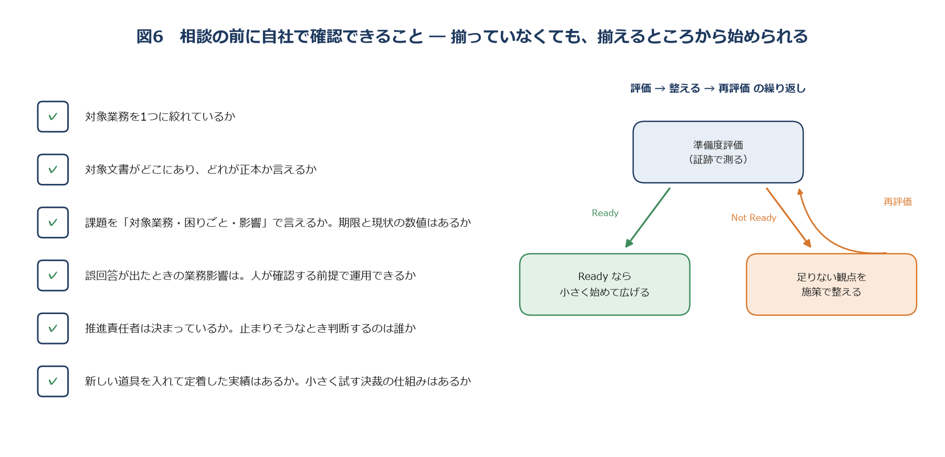
導入を考えている方が、相談の前に自社で確認できることを置いておきます。
- 対象業務を1つに絞れているか(複数にすると18問の答えがぼやけます)
- 対象文書がどこにあり、どれが正本か言えるか
- 課題を「対象業務・困りごと・影響」で言えるか。いつまでに解決したいか。現状は件数・時間・金額で分かっているか
- 誤回答が出たとき業務にどう影響するか。人が確認する前提で運用できるか
- 推進責任者は決まっているか。止まりそうなとき判断するのは誰か
- 最近、新しい道具を入れて定着したものはあるか。小さく試して失敗を許容する決裁の仕組みがあるか
結論:揃っていなくても導入できないわけじゃありません。揃っていない観点を先に整えるところから提案します。
今年一年、生成AI案件をやって一番感じたのは、「モデルが賢くなるほど、準備の差が結果の差になる」ということでした。来年はもっとモデルが賢くなるはずなので、その差はさらに開くと思っています。
「いまどこまで準備できているか」を一緒に測るところから、お気軽にご相談ください。
では、皆さん、また!